2026年9月24日,来自清华大学智能产业研究院的李航教授在王克桢楼1113室作了题为“大语言模型的可解释性”的报告,毕彦超教授主持报告。
撰文:滕晗
审核:毕彦超
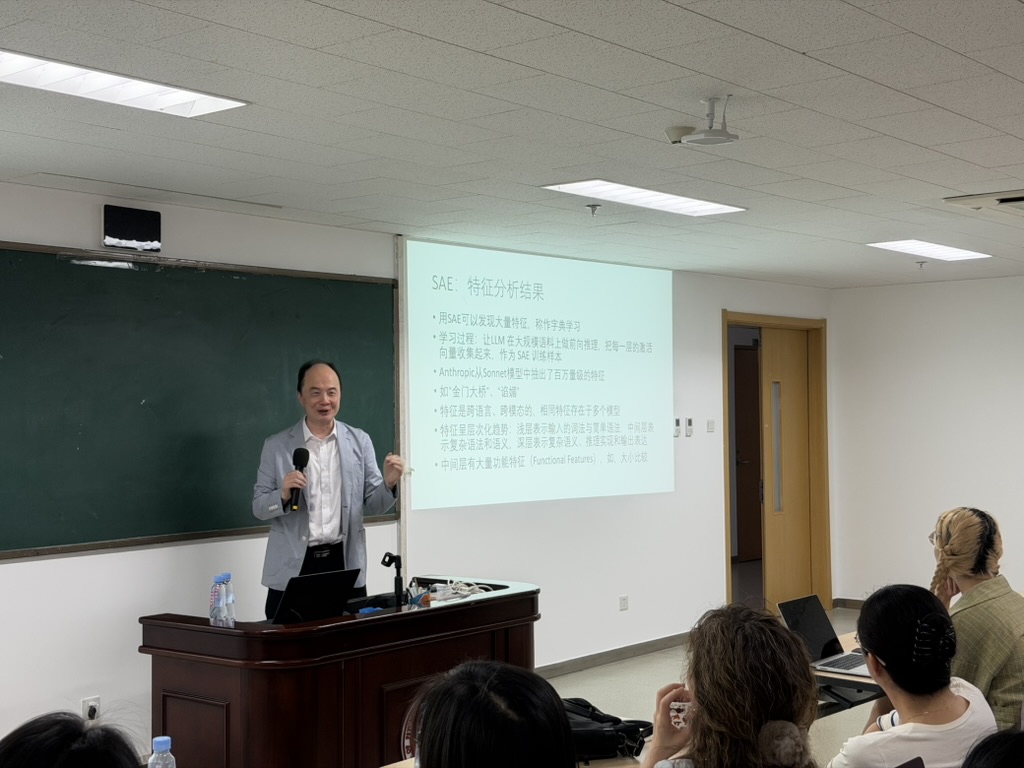
大语言模型已经能够流畅对话、创作诗歌和回答复杂问题,但这些能力如何从内部计算中产生,仍有许多未解之处。知道模型的结构与训练方法,并不意味着理解它完成具体任务的过程。可解释性研究希望把模型给出答案的过程变得可追踪,帮助人们理解它的能力与局限。围绕这一问题,李航教授介绍了分析模型内部机制的研究进展,并分享了他与合作者对大语言模型记忆机制的探索。
看见模型内部的计算
李航教授首先介绍了“特征叠加”:模型可以在有限的表示维度中容纳更多特征,不同特征共享神经元。稀疏自编码器(SAE)尝试从混合的神经元活动中提取可解释特征,帮助研究者辨认模型所表示的信息。跨层转码器(CLT)则用可解释特征近似模型中的部分计算,为追踪特征之间跨层的联系提供基础。研究者据此构建“归因图”,分析这些特征如何相互影响、共同参与回答的形成,并通过增强或抑制特定特征,检验对计算过程的解释。
报告以 Anthropic 的研究展示了这类方法带来的发现。在一些押韵诗的例子中,模型会在一行诗开始前激活与候选行末词相关的特征,并据此组织整行表达。改变这些特征,诗句的结尾和组织方式也会随之变化。这提示,逐步生成文字的模型也可能提前规划。加法研究则提示,模型对自身计算方法的描述,未必忠实反映实际的内部过程(Lindsey et al., 2025)。
报告还涉及多语言表征、幻觉和越狱等问题的机制分析,也介绍了 Anthropic 依据 Claude 宪法塑造助手角色的做法。
从功能词元理解记忆
模型中的知识如何被学到,又如何在需要时被调用?李航教授介绍了他与合作者在字节跳动开展的研究,提出了“功能词元假说”。
词元是模型处理文本的基本单位,不一定对应一个完整的词。研究将“the”、逗号、换行等高频词元归为功能词元。这些看似不起眼的语言和格式成分,可能在模型的学习与信息调用中发挥重要作用。研究提出,在生成回答时,功能词元所在的位置可以重新激活上下文中有助于预测的信息;在训练时,预测功能词元之后的内容,则推动模型学习新的特征、更新参数。作者用“记忆检索”与“记忆巩固”概括这两个过程,将学习与调用联系起来(Zhang et al., 2025)。李航教授据此强调,训练数据的组织形式也值得关注。这一视角为理解语言结构与模型学习之间的关系提供了新的线索。
本次报告展示了可解释性研究如何把对模型行为的观察转化为对内部计算的分析。对于脑科学研究者,信息如何被表征、知识如何在学习中形成、已有信息如何被调用,都是值得关注的共同问题。围绕具体任务提出机制假设,并通过干预加以检验,也为人工智能与脑科学之间的交流提供了具体议题。
参考文献
Lindsey, J., Gurnee, W., Ameisen, E., Chen, B., Pearce, A., Turner, N. L., Citro, C., Abrahams, D., Carter, S., Hosmer, B., Marcus, J., Sklar, M., Templeton, A., Bricken, T., McDougall, C., Cunningham, H., Henighan, T., Jermyn, A., Jones, A., . . . Batson, J. (2025, March 27). On the biology of a large language model. Transformer Circuits Thread. https://transformer-circuits.pub/2025/attribution-graphs/biology.html
Zhang, S., Lin, Y., & Li, H. (2025). Memory retrieval and consolidation in large language models through function tokens. arXiv. https://doi.org/10.48550/arXiv.2510.08203
2026-10-03